
你让一个系统「查清这笔订单为什么处理失败,并给出或执行符合规则的处置」。
系统第一次动手之前,它知道的是任务目标和可用接口,但不掌握这笔订单的具体失败原因——不知道是该重试、该继续查询、还是该转人工。它面前没有一条现成的、可以直接执行的指令链。
它必须先做一件事——获得信息。查订单状态,看处理记录,问依赖服务。每查到一点东西,它才有依据决定下一步做什么。而下一步做完,又产生新的信息,逼它再判断一次。
这个「看一点、动一下、再看结果、再决定」的往复,指向一个具体的问题:一个系统怎样根据目标和观察,自主决定下一步行动。
这不是 LLM 发明的新问题。早在语言模型能写代码之前,Agent 研究就一直在回答它。真正发生变化的是另一件事——解决这个问题的若干环节,承担者从人工知识工程或专门模块,部分转移到了语言模型上。系统依然需要提供观察、执行动作并判断结果——具体职责如何分配,因架构而异。
后面会陆续提到几篇关键工作(WebGPT、SayCan、ReAct、Reflexion、Voyager、SWE-agent),但这里先不急着列它们。它们不是一条「从 A 继承到 B」的发展线,更多是同一批人用不同方法回答同一个问题的不同侧面。先把「决定下一步」这件事本身拆开看,再谈这些工作各自补上了哪一块。
一、决定下一步,到底涉及哪几件事
把「决定下一步」拆开,一个系统每次做行动决策,至少要分清五件事。
目标:系统试图达到什么结果,谁定义这个结果是否合格。「查清失败原因并处置」是一个自然语言目标,但它没告诉你什么算「查清」、什么算「处置到位」。
环境:真实在变的外部系统。订单库里那笔订单的状态、库存、支付通道的返回——这些是环境,不是系统自己内部的东西。
观察:系统通过接口实际拿到的那部分信息。环境里有十件事,系统可能只看到两件,而且这两件还可能过时、缺失、有歧义。
「环境」和「观察」之外,还藏着两层容易混的东西。拿订单说:
- 那笔订单在数据库里真实是什么状态,这是环境;
- 系统查询后拿到的返回,这是观察;
- 系统把这次查询写进日志,这叫 Runtime 记录——它既不是环境,也不能保证下一轮真的被用上:日志里存了一堆字段,不代表模型下次输入里真的放了这些字段;
- 系统据此下了「库存为 0,不能再支付」这个结论,这是在观察之上做的推理,也不是观察本身。
同一个事实,可能落在四个不同的位置。很多「系统不知道自己不知道什么」的故障,根源就是把这四层混成了同一层。
行动:可选的动作,以及这些动作怎样影响环境或获取信息。查询订单是一种行动,重试支付是另一种,转人工又是另一种。
评价:结果是否达到了完成条件。这里要分清评价信号和真实业务结果——评价信号是系统用来判断「成没成」的那个指标,它可能和业务真正想要的结果之间有差距。
用订单案例把这几件事串起来,就能看出它们为什么不能混为一谈。
系统不知道失败原因,第一反应是查询。这里有个容易漏掉的点:查询不改变任何业务对象,它只是减少系统的不确定性。一个「读」的动作,同样是在影响后续决策——查完之后,系统才知道该不该重试。
执行之后要看结果。这里又有一个坑:订单接口返回 200,只说明这一次请求成功到达并被处理了;返回的订单状态是否足以回答用户的问题、是否需要继续行动,是另一个问题。返回 200 和「问题已经解决」,是两码事。这个坑的根源,就是评价信号和业务结果之间的落差——「请求成功」是一个很容易拿到、也很容易被误当成「事情办成了」的信号,但用户真正要的是「这笔订单处理好了」,这两者隔着好几步。系统如果拿「接口返回 200」当完成信号,它就会在订单其实还没处置完的时候就停下来。
最后,完成条件必须独立判断。不是「系统觉得自己做完了」就算完,而是「结果能不能对得上目标定义的那个合格标准」。
这五件事,没有一件是 LLM 带来的。传统 Agent 研究在几十年前就用另一套办法在回答它们。

二、传统 Agent 怎么选择行动
传统 Agent 研究怎么选行动,要先分清两个不同的问题:一个是运行时怎么组织行动,一个是行动规则怎么获得。前者问「当下这一步怎么选」,后者问「选动作的那套规则从哪来」。它们经常被并排说成「几条路线」,其实不在一个层面。
先看运行时怎么组织行动,有反应式和审慎式两种典型做法,以及两者的混合。
反应式设计:直接根据当前观察或内部状态,快速映射出一个动作。看到「库存不足」,就停掉支付重试。它的好处是快、不需要环境模型;代价是难以表达长期目标——它不知道为什么停,只是「这个状态对应这个动作」这条规则在起作用。这里说的只是规则的一种简单实现方式,不能据此断定所有传统方法都是写死的 if-else。
审慎式设计:借助知识或环境模型,先组织未来的行动再执行。它需要三样东西:动作的前提条件(什么时候能做这个动作)、动作的效果(做完会变成什么样)、目标条件(什么样算到达终点)。用这三样,它可以推演「先查状态,如果超时就查实际结果,如果库存不足就换方向」。
这三样东西怎么组织推演,决定了审慎式设计的强弱边界。为了看清推演,先给这个教学环境定一套自洽的规则。每个动作都有前提、效果:
- 查询支付状态:前提是「尚未确认支付结果,且查询接口可用」;效果是「得到成功、失败或仍未知的观察」。
- 重新发起支付:前提是「已确认此前支付失败,且这个教学系统允许重试」;效果是「发起一次新支付,实际结果仍需查询或接收回调确认」。
- 目标条件是「订单已处置」。
现在推演就能跑起来了:系统从「结果未知」这个状态出发,「重新发起支付」的前提(已确认失败)并不成立,所以它只能先选「查询支付状态」。查到「失败」之后,重试的前提才被满足,这时才轮到「重新发起支付」。推演的力量在于,它能在一串动作执行之前,先检查每一步的前提在推演到的那个状态下是否成立——如果推演到「库存不足」,而下一步计划是「重新发起支付」,前提对不上,它就能在动手之前发现这条路走不通。
代价也在这里:这套推演要成立,前提、效果、目标条件都必须事先写清楚,而且这些前提一旦写死,就假设了环境按这些规则来。真实环境未必如此——「查询支付状态」可能超时、可能返回一个过期的结果,这时「已确认失败」这个前提本身都拿不准,推演就失去了抓手。环境知识越缺,推演越脆弱。这就是为什么审慎式设计和反应式设计会互相补充,而不是谁取代谁。
学习式设计:它不事先写死规则,而是通过和环境交互、拿到反馈,自己把「怎么选动作」的规则调出来。走一遍是这样:环境给一个观察,系统按当前策略选一个动作,环境再返回一个奖励(这个动作到底好不好),系统拿这个奖励去改策略——下次再遇到类似观察,就更可能选收益高的那个动作。
这里有一条边界值得记住:拿到反馈,不等于真的在「学习」。学习的关键是「选动作的规则被改动了」。如果只是把这次的结果记下来、规则一点没动,那不叫学习。而「规则」这个对象本身,可以是张查表、一组 if-else,也可以是个神经网络——它们都是「从观察映射到动作」的不同写法,改动发生在哪个对象上,含义完全不同。
因为「怎么组织行动」和「规则怎么获得」是两个维度,同一个系统可以两边都占:一个反应式策略,规则既可能是人写死的,也可能是训练出来的;一个审慎式规划器也一样。所以「反应式」和「学习式」不是二选一,而是同一个系统在两个维度上的不同属性。
真实系统往往把反应式和审慎式混在一起:既有长期计划,又保留即时反应。因为一个任务既需要「往哪个大方向走」,也需要「遇到突发情况立刻停手」。
这两种做法对「环境知识、计算资源、交互经验」的要求完全不同,但它们都在回答同一个问题:下一步选哪个动作。 它们的共同难点也一致——环境知识要么得提前写死,要么得让机器在特定环境里反复试错。而真实世界的目标是用自然语言说的,环境接口五花八门。
传统 Agent 里还有一个常被提起的名词 BDI(belief-desire-intention,信念-愿望-意图),它试图把「系统相信什么、想达到什么、当前承诺做什么」这三件事形式化地区分开。其中最有价值的一个区分是:系统「想要」的结果,和系统「当前承诺正在做」的动作,是两个不同的东西——「想要」不必然等于「正在做」,「正在做」也不必然等于「正在做对的那件事」。这个区分在后面讲 LLM Agent 时还会用到——很多「Agent 卡住了」的故障,根因之一就是「承诺在做的事」已经偏离了「想要的结果」。
有没有一种东西,既懂自然语言目标,又能适应没见过的环境?这就是语言模型被拉进来的原因。

三、LLM 进来之后,改变的是哪一环
LLM 改变的,不是「要不要闭环」,而是闭环里任务表达和行动选择这两件事,从人工写死的规则和专用模块,部分转移到了「预训练参数 + 任务时上下文 + 外部工具」的组合上。观察、执行、评价这几环依然主要由系统承担——外部工具负责把环境状态变成可读的信息,执行层负责真正落地动作,评价环节负责判断结果是否达标。
这三层必须分开看。
预训练参数:模型在训练时学到的语言能力和世界知识,固化在权重里。它是模型能用 prompt 产生回答的基础之一,但模型「实际能输出什么」还取决于后训练、推理时的解码方式、输入和工具——这些都不只在参数里。
任务时的指令和示例:这次任务里喂进去的东西。给几个例子、描述清楚目标,模型的本次输出就可能不同。注意,in-context learning 是通过输入影响模型输出的机制,与「更新权重」是两件不同层面的事(Brown et al., 2020)。
这两层的区别,是理解 LLM Agent 的一个关键。
改输入,不改权重。 在不更新权重的前提下,指令、示例、观察都是通过「输入」来影响模型输出的。系统想让它换个行为,不用重新训练,只要换一换喂进去的东西就行。这正是 LLM Agent 区别于「每换一个任务就重训一个模型」的地方。
输入的影响能持续多久,由系统决定,不由模型决定。 任务结束,上下文不一定自动清空——保不保留、什么时候清理、下次任务还继不继续用,都是应用层的选择。所以「这一次输入触发的行为」能活多久,取决于系统之后还会不会继续把这些信息喂回去。
把这两点合起来:模型的能力来自训练,但模型这一次任务里的表现,是被输入临时塑造的。同一个模型,换个上下文就可能表现差别很大——很多人看到某次任务跑得好,就以为模型「学会了」,其实更可能是上下文喂得对。
外部工具:模型不自己算库存,它调一个工具去算。工具承担了「精确执行」的部分,模型承担了「判断何时需要、怎么用结果」的部分。
自然语言为什么有助于组织任务?因为它能表达目标、描述工具、记录观察、总结经验,而且天然能迁移到不同任务——同一个模型,既能查订单,也能写代码。但这里要留一个心眼:自然语言表达可能不完整、不精确、甚至不能直接执行。能说清楚,不等于已经理解对。
回到订单案例就能看清这个缝隙。「查清失败原因并处置」这句话,人一听就懂,但作为给系统的目标,它漏掉了太多东西:什么叫「查清」?查到哪个程度算够?「处置」是只能给建议,还是可以直接退款?这些没写出来的东西,模型得靠自己的常识去猜。猜对了任务就顺,猜错了方向就偏。这些目标缺失的字段必须由人或者既有政策事先定义(什么时候能退款、退款的金额上限),不能在事后用「评价环节」补——评价只能判断结果是否满足一个已经定义好的标准,不能凭空造出标准。自然语言的灵活性,和它作为「目标规格」的不精确,是同一枚硬币的两面。
中间推理(Chain-of-Thought)是这里最容易被误解的一环。必须把三件事分开:
- 输出里出现了中间步骤;
- 这些中间步骤让某项任务表现变好了;
- 这些中间步骤忠实呈现了模型内部的因果推理过程。
第一件和第二件都被实验证实过——CoT 用 few-shot 示例,让足够大的模型在数学、常识、符号推理上表现跃升(Wei et al., 2022)。但第三件没有被证实,而且有证据反对它:有研究发现,给输入加一些偏置特征(比如把选择题的选项顺序重排,让答案总是 A),模型会给出迎合这个偏置的答案,却在自己的推理文本里完全不提这个偏置(Turpin et al., 2023)。也就是说,看得见的推理轨迹,不等于模型真实的决策依据。
这还不是语言模型接触环境的全部。工具能力本身也有训练层面的研究:Toolformer 让模型自己学会「什么时候该调工具」(Schick et al., 2023)。做法是:先让模型猜出一些可能要调用的工具,真去执行一遍,再判断「加了这次工具调用和结果之后,模型是不是更容易接上下文」——只保留那些确实让模型更顺的样本,用它们去微调权重。它是训练层面的方法,而且明确不能链式调用、不能交互式使用。
同样的道理,也适用于「规划」。模型能输出一个看起来合理的多步计划——先查状态、再判断、再处置——这件事本身,不等于这个计划真的会在执行中成立:计划里每一步的前提,可能在前一步做完之后已经变了;环境可能在计划执行到一半时改了;也可能根本没有一个环节在检查「是不是该停下来」。生成一份编号列表和完成一次规划,隔着的是分支、评价、搜索、重新规划这些东西——即「谁在选择下一步、计划什么时候改、谁决定终止」的机制。这些是语言模型本身不自动提供的,要靠系统层面补上。
把这些合起来,结论是:LLM 让「决定下一步」这件事的表达和选择变得灵活了,但它没有让闭环消失。模型「说出」一个动作,离环境「执行」它,中间还隔着任务相关性、可行性、授权、结果四道坎。
四、从「提出动作」到「依据环境继续决策」
一条真实的数据流是这样的:
任务和已有观察 → 形成模型输入 → 模型提出动作 → 执行层尝试执行 → 得到结果 → 更新后续输入 → 再选择行动。
关键不在箭头有几个,而在新观察怎样进入下一轮输入。只输出一段带着 Action 和 Observation 字段的文本,不足以证明真的发生了环境交互——交互要成立,至少要满足三层证据:(1) 一次真实的执行确实尝试调用了外部环境;(2) 执行得到的结果被传回给了下一轮的输入;(3) 该结果对模型本轮的输出产生了可观察的影响。一次查询可能返回和上次相同的结果,正确决策也可能不变——所以「观察是否真的改变了判断」本身需要可测量的证据,不是默认假设。
这里要分清四件不同的事:
- 任务相关性:这个动作是否有助于目标。
- 可行性:当前环境是否具备执行这个动作的条件。
- 授权:系统是否允许执行。
- 结果:执行后是否达到预期。
这四件事,任何一个都可能单独出问题,而它们常常被当成一回事。早期研究里,SayCan(Ahn et al., 2022)就把「相关性」和「可行性」分开处理了:它让语言模型回答「这一步该做什么」,再让另一套技能系统回答「这一步在当前环境里做不做得到」,两个答案相乘来挑下一步。这是机器人场景里的做法——它处理的是相关性和可行性,不是企业系统里的权限检查。相似的问题,不同的机制,不能直接搬过来。
回到订单案例,这四件事各有各的翻法。
先看相关性和可行性。请求超时,不说明外部操作没成功——超时只是「没收到响应」,实际可能已经成功,需要查实际状态;观察到库存不足,就不能继续重复支付请求,得转向和库存相关的下一步。原计划的前提变了,计划就不能无条件执行下去。
再看授权。「直接退款」这个动作,从任务上看它有助于处置订单,从环境上看退款通道也正常,但系统可能根本没被授予退款的权限,只能给人工建议。模型「认为该退款」和「系统允许退款」,是两个独立的判断,前者再正确也不能越过后者。
最后是结果。执行了退款,还要看退款是否真的到账、订单状态是否真的更新——执行动作,和执行后的结果达标,又隔着一层。
四件事,任何一环断了,整个「决定下一步」就错了。但它们断的方式完全不同,排查时也要对着不同位置找。
语言模型接触浏览器、机器人这类外部环境,不是 ReAct 开的头。WebGPT 在 2021 年就微调 GPT-3,让它会搜索、浏览网页并引用来源(Nakano et al., 2021)。ReAct 自己也承认,它参考了更早的 Inner Monologue 这个「据作者所知此类闭环系统的首个工作」;ReAct 真正的贡献,是把「语言推理」和「外部动作」交错进同一个循环,让想一步、做一步互相喂信息(Yao et al., 2022)。
把这三份工作放一起,能看到「接触环境」这件事至少拆成三个不同的重点。它们不是一条继承链,更像是三个方向各取所需:
- WebGPT 盯的是「怎么训练」:用微调加人类反馈,把一个语言模型改造成会浏览网页的问答器。代价是构造人类反馈成本高。
- SayCan 盯的是「怎么把想和做对齐」:让语言模型提高层步骤,再让技能系统筛掉当前环境做不了的,两步结合来挑动作。代价是每个新场景都要先训练一套技能。
- ReAct 盯的是「怎么组织推理和行动」:把「想一步」和「做一步」放进同一个循环交替进行。代价是 prompt 要管理上下文长度。
三件事各自有各自的取舍,也都包含这里没展开的其他环节(工具实现、记忆、评价信号),只是分析重点不在那。它们共同说明一件事:让语言模型「接触环境」不是一个开关,而是「怎么训练、怎么对齐、怎么组织」几个可以独立选择的问题。
一个闭环让一次任务能跑通。但这一次任务里积累的反馈,怎么变成「下一次任务」的经验?这是两个完全不同的问题。
五、反馈、反思与经验,三种时间尺度
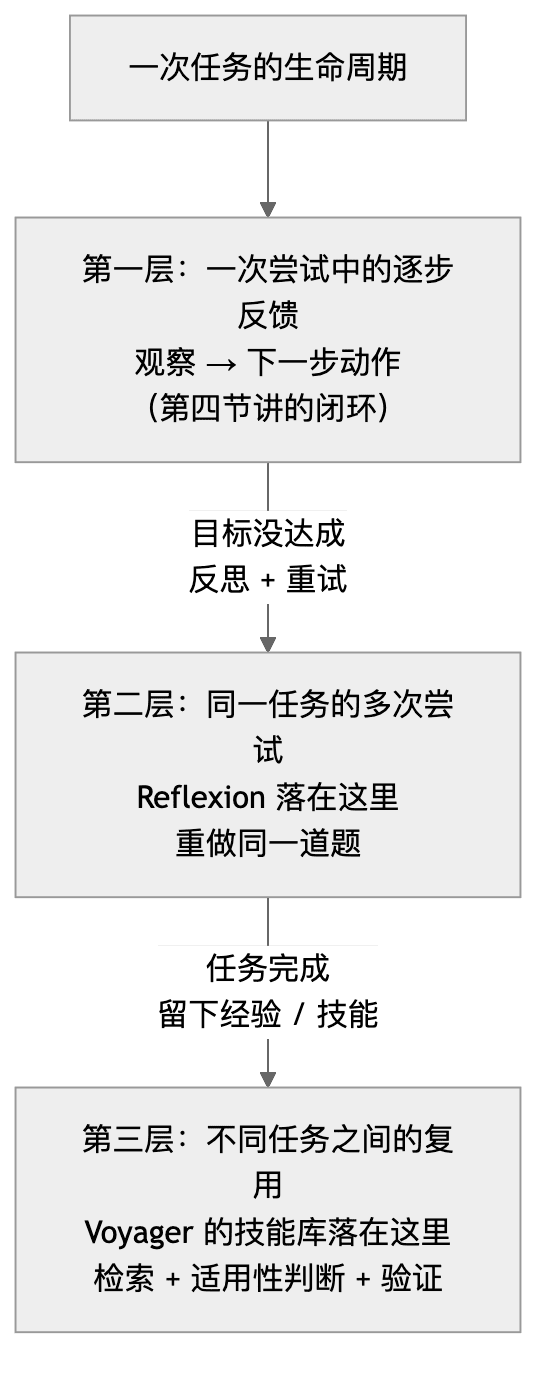
「Agent 会学习」这句话,把三件不同的事揉在了一起。下面把它们按时间尺度分开。
一次尝试中的逐步反馈:执行一个动作,依据观察决定后续动作。这是第四节讲的闭环,作用范围只在这一次尝试的内部。
同一任务的多次尝试:任务目标不变,第一次没做成时反思调整,再次尝试完成原目标。重做同一道题、再次修同一个函数,都属于这一类。Reflexion 处理的就是这个层级——它「reset environment, start a new trial」,任务本身不变,只是同一任务的新一轮尝试。
不同任务之间的复用:任务 A 留下的经验或技能,在任务 B 中被选择和使用。Voyager 的技能库落在这里——一次 Minecraft 任务写下的可执行代码,下次在另一个场景里检索出来当作「技能」用。
把这三层混在一起是常见的混淆来源。「看了结果改了动作」属于第一层,「同一题重做」属于第二层,「以前的经验被新任务用上」属于第三层。第三层需要更完整的检索、适用性判断和验证机制;前两层不一定需要。
Reflexion 落在第二层。它的闭环涉及六个环节:
- 谁执行任务:actor,一个语言模型,负责生成动作。
- 谁评价结果,依据什么:evaluator。在编程任务里,它的依据不是「看起来对不对」,而是跑一遍自生成的单元测试,测试过不过,是二元信号。
- 反思用哪些输入:actor 这次失败的轨迹 + evaluator 给的「失败」信号。反思模型把这两个输入转成一段自然语言,指出「具体哪一步做错了、下次该怎么做」。
- 反思存到哪:一个长期记忆缓冲区,容量很小,通常只留 1 到 3 条经验。
- 后续怎么读回:下一轮 actor 开工时,除了当前任务的历史,还把这些反思一起塞进上下文。
- 何时停止:评估通过,或者达到最大尝试次数。
这六个环节合起来,说明 Reflexion 到底「学习」了什么(Shinn et al., 2023):它没动模型权重,只改了下一轮 actor 能看到的上下文。所谓「verbal reinforcement learning」,说白了就是把「失败」这个很稀薄的信号,扩写成一段能被下一轮读懂的、具体到「改哪一步」的文字,再塞回上下文。这跟通常说的强化学习不一样——强化学习是用奖励信号去更新模型权重,而 Reflexion 只是改变了系统的行为条件。两者名字里都带 reinforcement,动的东西却完全不同。
Reflexion 的关键不在「模型反思后变聪明」,而在评价信号的可靠性决定了反思的质量。它自己就翻过车:自生成的单元测试会有假阳性——测试全过、实现其实是错的,导致它过早判定成功、交了错误答案,在某几个数据集上结果反而不如不反思。还有一条更反直觉的消融结论:只留反思、去掉测试生成,效果反而更差。这说明没有可信评价来源的反思,是帮倒忙的。反思不是免费的午餐,它依赖一个靠谱的评价来源。
跨任务的技能复用,看 Voyager(Wang et al., 2023)。它的流程是:自动课程提任务 → 从技能库检索相关技能 → 生成代码 → 执行拿反馈 → 自验证 → 把验证通过的代码存回技能库。技能是可执行的程序,存在向量库里。有两个细节:
- 检索出来的代码不是被直接调去执行任务,而是作为示例喂进 GPT-4 的输入,引导它生成新代码。也就是说,它起到的是「参考样例」的作用,不是「拿来就用」。
- 「任务完成」由另一个 GPT-4 来判定,是个启发式判断,论文自己也承认会判错(比如没认出蜘蛛丝是打败蜘蛛的成功信号)。所以它没有普遍的正确性保证。
消融实验也证实,去掉技能库、去掉课程、去掉自验证,性能各自都明显下滑。
和 Reflexion 对照着看,能看到「经验」的两种完全不同的表示方式。Reflexion 存的是自然语言反思——一段「上次哪步错了、下次怎么做」的文字,靠塞回上下文来影响下一轮。Voyager 存的是可执行程序——一段已经跑通、验证过的代码,靠嵌入相似度检索出来当作「技能」用。前者的价值在「提醒模型注意什么」,后者的价值在「直接把一个验证过的能力搬过来」。
两者都要面对同一个问题:存下来的经验,下次怎么找到、怎么判断还适用。Reflexion 靠的是固定小缓冲,容量一到就顶掉旧的;Voyager 靠的是向量检索,但检索回来的代码也可能因为环境变了而不再适用——而且它只是塞进 prompt 让模型参考,不保证生成的代码在新场景下能跑通。记录成功,和「之后能找到并正确用上」,中间隔着一整套检索、匹配、验证的机制。
这里要小心一个类比陷阱:Voyager 里的可执行程序、某些产品里的 SKILL.md 文件、人类的认知技能,都「复用经验」,但不是同一个技术对象——表示方式不同、执行方式不同、验证方式不同。可以讨论它们共同关注复用,但不能画等号。
用一张表把「改变发生在哪里」看清楚:
| 改变位置 | 要问的问题 |
|---|---|
| 模型参数 | 是否发生了训练更新?用了什么数据或反馈? |
| 当前上下文 | 加了什么信息?作用持续到什么时候? |
| 外部记忆 | 保存了什么、怎么找回、何时进入模型输入? |
| 可执行技能 | 谁生成、如何验证、怎样检索和组合? |
| 环境接口 | 返回了什么新信息,减少了什么判断负担? |
记录下一条成功经验,不等于之后能找到并正确用上它。 错误经验、过时环境、检索噪声、技能前提不满足,都是复用的代价。回到订单案例,得到一条「过去这类超时后来是成功了的」经验,先要判断它的适用条件,再决定采不采用——而不是拿来就用。
把这条边界说实一点。假设这条经验是「支付失败时直接重新提交」。它以前是对的——老通道的「失败」返回意味着已确定未扣款。但新通道改成「失败」必须先调用查询接口、拿到上一笔请求的最终状态后再返回。这种情况下,旧经验会直接触发重试,根本没去查实际状态,结果是把一笔已经扣款、只是回调延迟的订单再次扣了一次。
旧经验错的不是「应该重试」这个判断,而是它没意识到接口契约变了:原来的「失败」= 不确定,现在的「失败」= 必须先查才能知道结果。经验的价值依赖于它被总结时的接口契约;接口一变,经验就可能从资产变成负债。所以「会存经验」和「会判断经验还适不适用」是两码事——评价经验是否仍然成立,比保存经验本身更关键。
这些机制放在一起说明一件事:能力来自模型、上下文、记忆、决策组织和执行层(加评价)的组合,不是只来自模型一个部件。这个组合的任何一个环节,都可能单独失效。
六、能力分布在系统的哪些环节
一个 Agent 不稳的时候,该查哪里?这个问题没有统一答案,因为能力可能分布在五个环节,任何一个都可能单独失效。
模型:根据输入生成推理、计划或动作候选。决策组织:决定模型何时被调、上下文怎么形成、下一步怎么推进。执行层:真正调用工具拿到结果。状态与记忆:保留当前任务的信息,以及要跨任务用的经验。评价:判断当前结果是否达到完成条件。
这五个不是标准术语,真实系统可能合并它们。它们的意义在于帮你定位问题:输入错了查模型和上下文,动作没执行查执行层,结果不对查评价,跨任务记不住查记忆。
工具接口这一层常常被低估,但它能实质改变模型的决策条件。SWE-agent 用消融实验量过这件事的分量(Yang et al., 2024):把专门的 edit 编辑命令拿掉、退回让模型用 shell 里的 sed 硬改,成绩掉得最狠;拿掉 linting 守卫(编辑后自动跑一遍检查、发现错误就撤销),也明显掉分。
最有反直觉的是搜索接口的对比。SWE-agent 默认给模型一个「汇总式」搜索——一次把匹配结果打包显示。换成「逐条浏览式」(像在编辑器里按 next/prev 一条条翻),成绩反而比不给搜索工具还差。原因在于,人看到一堆结果会跳过不相关的,模型却做不到——它会一条条穷尽式地翻下去,把上下文窗口和预算耗光。一个看似更「顺手」的接口,反而把模型带进了坑里。
这些是「接口改变决策条件」的证据,不是「权限治理」的证据。提高可操作性、减少错误传播、权限隔离、业务授权,是四件不同的事,用一种功能的证据去证明另一种,是越界。
CoALA(Sumers et al., 2023)是套有用的组织工具:它把记忆、行动、决策都分成了几类,方便你说清「这项新能力到底落在哪一层」——比如「这条经验是存在上下文里,还是存进长期记忆了」。但它是一篇概念框架,回顾性地整理已有工作,不是实验结论,也不能当成组件清单照抄。
回到订单案例,「查库存」这一个动作,接口返回的信息密度不同,会直接影响模型下一步判断。接口怎么设计,决定了模型能看到什么——但更多字段未必更好,关键在于返回的内容是不是这次决策需要的、是不是可靠的。SWE-agent 里有个相关的观察:把文件查看窗口从一小段扩到合适的范围能涨分,但把整个文件无限制地全丢给模型,反而掉分——超过某个限度,噪声就开始淹没信号。接口的设计目标不是「越多越好」,而是「刚好够完成当前决策」。
七、回到那个订单,你会怎么判断
现在,拿到一个陌生的 Agent 方案,你可以依次问它六个问题:
- 它的目标和成功标准是什么,谁定义的?
- 它实际看到了什么,还有哪些信息它不知道?
- 下一步由谁、根据什么选出来的?
- 行动怎么执行,结果怎么回到后续决策?
- 经验存在哪里,下次使用时怎么影响行为?
- 它新增的能力在哪一层,证据能支持多大范围的结论?
用这六个问题回头再看开篇那个订单任务。系统卡住了,先别急着调模型。要分清是哪一环失效:
- 决策问题:观察已经拿到关键信息,但模型选择了不适当的下一步(用了过时的经验、漏了某个前提、把无关动作当成了相关动作)。
- 执行问题:动作选得合理,但调用工具失败、权限拦截、接口超时——决定没问题,落地这一步断。
- 评价问题:执行成功、结果拿到了,但系统判成「完成」——可能是完成条件定义得过于宽松(拿 200 当办成),或者是评价信号和业务结果之间有落差。
这三种排查方向对应的修法不一样:决策问题要换上下文或换策略;执行问题要查接口、查权限、查重试;评价问题要重新定义完成标准。观察不足(没查到关键信息)也是一类常见失效,它属于输入端问题,不在上面三类之内,需要扩大查询或换接口。
决定下一步的闭环——目标、观察、行动、反馈——从来没有因为 LLM 而消失。LLM 让任务表达和行动选择变得更加灵活,可以由语言推理承担原先需要人工知识工程或专用模块的工作;但观察来源、动作执行、结果判断这几环,依然要由外部工具、执行层和评价机制提供。一个具体系统里哪些环节交给语言模型、哪些环节由代码或人工保证,要看架构选择——不能用一个整齐的「全迁移」图景去描述所有 LLM Agent。但「看一点、动一下、再看结果、再决定」这个基本结构,从传统 Agent 到语言智能体,一直是同一个。
至于「下一步」到底该由谁拍板——是模型、是代码、还是一份事先写好的计划——那是另一个问题,下一篇接着讲。
参考资料
本篇正文里引用到的研究,按首次出现顺序排列:
- Wei et al., 2022. Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. arXiv:2201.11903. https://arxiv.org/abs/2201.11903
- Nakano et al., 2021. WebGPT: Browser-assisted question-answering with human feedback. arXiv:2112.09332. https://arxiv.org/abs/2112.09332
- Ahn et al., 2022. Do As I Can, Not As I Say: Grounding Language in Robotic Affordances (SayCan). arXiv:2204.01691. https://arxiv.org/abs/2204.01691
- Yao et al., 2022. ReAct: Synergizing Reasoning and Acting in Language Models. arXiv:2210.03629. https://arxiv.org/abs/2210.03629
- Schick et al., 2023. Toolformer: Language Models Can Teach Themselves to Use Tools. arXiv:2302.04761. https://arxiv.org/abs/2302.04761
- Shinn et al., 2023. Reflexion: Language Agents with Verbal Reinforcement Learning. arXiv:2303.11366. https://arxiv.org/abs/2303.11366
- Turpin et al., 2023. Language Models Don’t Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting. arXiv:2305.04388. https://arxiv.org/abs/2305.04388
- Wang et al., 2023. Voyager: An Open-Ended Embodied Agent with Large Language Models. arXiv:2305.16291. https://arxiv.org/abs/2305.16291
- Sumers et al., 2023. Cognitive Architectures for Language Agents (CoALA). arXiv:2309.02427. https://arxiv.org/abs/2309.02427
- Yang et al., 2024. SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering. arXiv:2405.15793. https://arxiv.org/abs/2405.15793
- Wooldridge & Jennings, 1995. Intelligent Agents: Theory and Practice. https://www.cs.ox.ac.uk/people/michael.wooldridge/pubs/ker95/ker95-html.html
留言
欢迎分享你的想法。评论提交后会在审核通过后显示。